関連記事
本記事は、Pythonの実装を見据えた上でのPLS回帰の記事です。
PLS回帰による次元圧縮の考え方や予測モデルの構築方法、予測精度の評価については、以下の記事でも詳しく解説しています。
 ケイエルブイは、ハイパースペクトルカメラ・光学部品・光源など世界中の光学機器を取り扱う専門商社です。
03-3258-1238
お問い合わせ
ハイパースペクトルカメラなどで取得したスペクトルデータを解析することで、試料に含まれる成分の濃度や含有量などを推定することが可能です。
例えば、食品に含まれる水分量や糖度、材料に含まれる特定成分の濃度などです。
ただし、スペクトルデータには多数の波長情報が含まれており、各波長の情報を単純に確認するだけでは、安定して定量的な値を求めることは困難です。
そこで、多波長のスペクトルデータを統計的に扱う手法として、PLS回帰(部分最小二乗回帰)があります。
PLS回帰を使うことで、スペクトルデータと成分濃度などの関係を解析し、未知試料の濃度を予測するためのモデルを構築することができます。
本記事では、Pythonを用いたPLS回帰による定量分析を行うために必要な基礎知識、モデル構築の基本的な流れについて解説します。
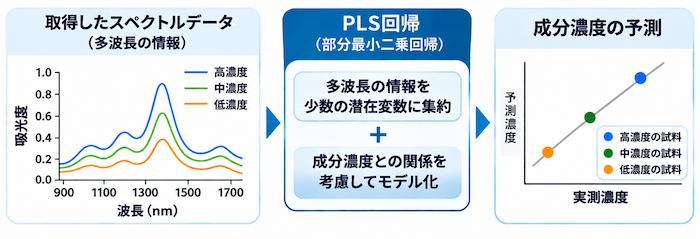
物質に光を照射すると、物質の種類や状態に応じて、特定の波長の光が吸収・反射・透過されます。
よって、特定成分の濃度が変化すると、その成分に関連する波長領域において、吸光度などのスペクトル強度が変化する場合があります。
この現象を利用して、スペクトルの変化と成分濃度の関係をモデル化することで、試料に含まれる成分濃度を推定することができます。
ただし、現実はもう少し複雑です。
実際のスペクトルには、目的成分以外の物質による影響や、測定条件の違い、ノイズなどが含まれているからです。
そのため、複数の波長情報のデータを取得し組み合わせるとともに、統計解析を用いることで予測精度を高める必要があります。
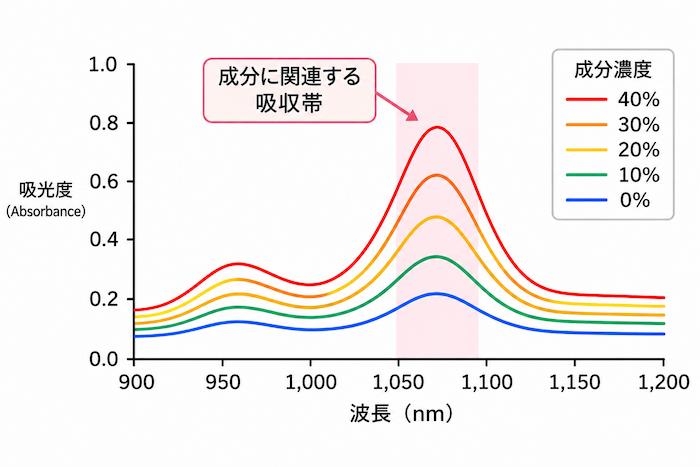
スペクトルデータからは、単一波長では得られない多くの情報を得ることができますが、隣接する波長の測定値は互いに強く相関していることが多く、そのまま重回帰分析を行うと、回帰係数が不安定になる場合があります。 これに対して、PLS回帰は、多数の波長情報を少数の潜在変数に集約することで、このような問題の影響を抑えながら定量分析モデルを構築できる手法です。
本記事は、Pythonの実装を見据えた上でのPLS回帰の記事です。
PLS回帰による次元圧縮の考え方や予測モデルの構築方法、予測精度の評価については、以下の記事でも詳しく解説しています。
もうすこし、PLS回帰の内容を明確にするため、一般的な重回帰分析とPLS回帰を比較してみます。
PLS回帰の大きな特徴は、以下の2点です。
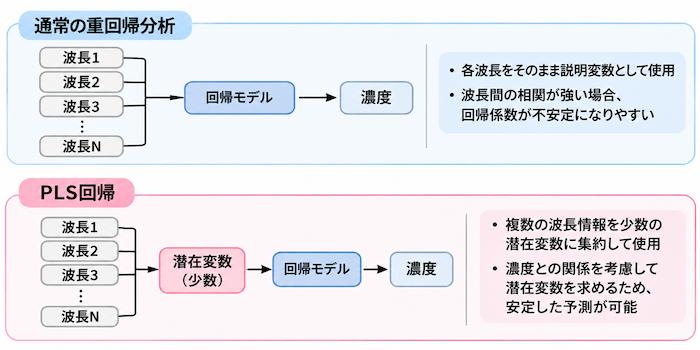
通常の重回帰分析では、複数の説明変数を直接用いて目的変数を予測します。
例えば、スペクトルの各波長における測定値を使用する場合、以下のような回帰式で表すことができます。
\( y \):予測する成分濃度
\( x_1, x_2, \ldots, x_p \):各波長の測定値
\( b_0 \):切片
\( b_1, b_2, \ldots, b_p \):回帰係数
ここで、500 nmと510 nmの吸光度がほぼ同じように変化する場合を考えます。
すると、
のように回帰係数が異なっていても2つの値はほぼ同じ予測結果になり、それぞれの変数濃度予測への寄与を分離することができないことがわかります。
つまり、スペクトルデータは、波長間の相関が強いため、全ての変数を使用すると係数が不安定になってしまいます。
一方、PLS回帰では、元の説明変数を組み合わせて少数の潜在変数を求め、それらを用いて回帰モデルを構築します。
例えば、500 nmと510 nmの吸光度がほぼ同じように変化する場合でも、それぞれの波長を独立した変数として扱うのではなく、両者に共通する変動を1つの潜在変数としてまとめたうえで、回帰を行います。
さらに、PLS回帰では成分濃度との関係も考慮しながら潜在変数を求めるため、濃度予測に役立つ情報を効率的に抽出できます。
このように、数百波長のスペクトルデータを数個の潜在変数に集約することで、波長間の強い相関による影響を抑え、安定した予測モデルを構築しやすくなります。
PLS回帰では、説明変数と目的変数の2種類のデータの用意が重要になります。
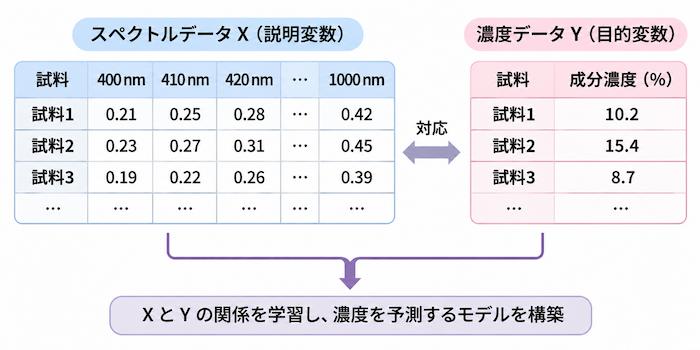
説明変数Xは各試料のスペクトルデータです。
例えば、100個の試料について、200波長のスペクトルデータを測定した場合、次のような配列データ構造になります。
| 試料 | 400 nm | 410 nm | 420 nm | … | 1000 nm |
|---|---|---|---|---|---|
| 試料1 | 0.21 | 0.25 | 0.28 | … | 0.42 |
| 試料2 | 0.23 | 0.27 | 0.31 | … | 0.45 |
| 試料3 | 0.19 | 0.22 | 0.26 | … | 0.39 |
| … | … | … | … | … | … |
目的変数Yは、各試料の成分濃度データです。
100個の資料のそれぞれの成分濃度なので、以下のような配列データになります。
| 試料 | 成分濃度(%) |
|---|---|
| 試料1 | 10.2 |
| 試料2 | 15.4 |
| 試料3 | 8.7 |
| … | … |
PLS回帰では、これらのXとYの関係を入力として学習することで、未知試料のスペクトルデータから成分濃度を予測するモデルを構築します。
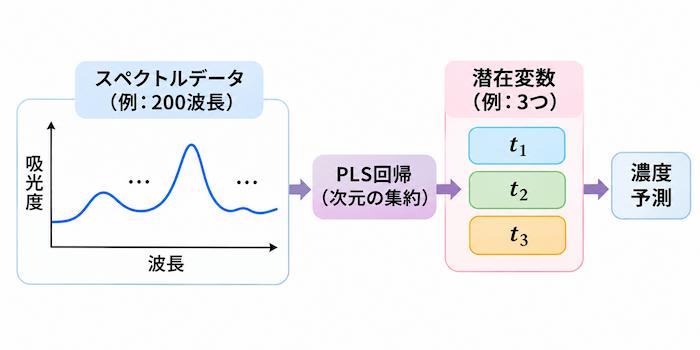
PLS回帰では、大量にある説明変数のデータを少数の潜在変数に集約します。
例えば、200波長のスペクトルデータから、元のスペクトルに含まれる特徴を表す3個の変数を求めます。
この3つの変数が、潜在変数です。
PLS回帰で潜在変数を求める代表的な計算方法の一つに、NIPALS法があります。
NIPALS法は、スペクトルデータと成分濃度データの関係を調べながら、繰り返し計算によって潜在変数を求める方法です。
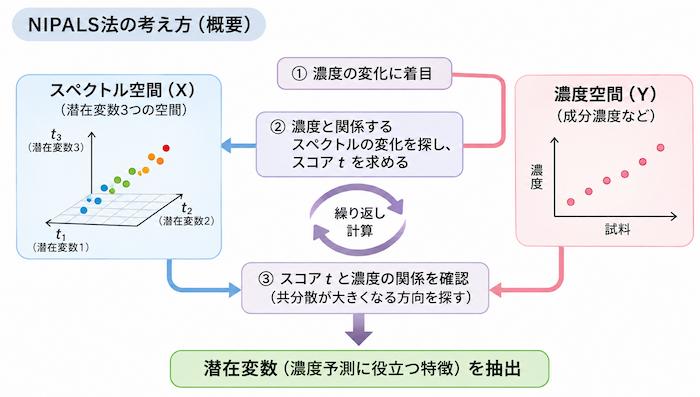
具体的には、次のような考え方で計算を行います。
まず、成分濃度がスペクトルに与える変化に着目します。
例えば、水分量が10%、20%、30%と異なる試料がある場合、それぞれの濃度の違いが、スペクトルデータにどのように反映されているかを調べます。
NIPALS法では、この濃度の変化と関係するスペクトルの特徴を探していきます。
STEP1の内容を元に、成分濃度の変化と関係が強いスペクトル波長を探します。
例えば、水分量が増えるにつれて特定の波長領域の吸光度も増加する場合、その波長領域には水分量の予測に役立つ情報が含まれていると考えられます。
NIPALS法では、1つの波長だけでなく、複数の波長の測定値を組み合わせることで、濃度の変化と関係する方向を求めます。
そして、その方向に沿って各試料のスペクトルデータを数値に変換します。この数値を「スコア」と呼びます。
スコアは、複数の波長情報を組み合わせて得られる値であり、各試料が抽出したスペクトルの特徴をどの程度持っているかを表します。
求めたスコアと成分濃度の関係を確認し、潜在変数を決定していきます。
このとき重要なのが、スコアと濃度データの「共分散」です。
共分散とは、2つのデータがどの程度連動して変化するかを表す指標です。
PLS回帰では、このスコアと濃度の共分散が大きくなる方向を考慮して潜在変数を求めます。
つまり、PLS回帰では、成分濃度の変化と関係が強いスペクトルの特徴を抽出するように、潜在変数を求めることができます。
また、1つ目の潜在変数を求めた後は、その潜在変数で説明できる情報を元のデータから取り除き、残った情報から次の潜在変数を求めます。
この操作を繰り返すことで、複数の潜在変数を順番に抽出ていきます。
PLS回帰では、抽出した潜在変数を用いて目的変数を予測します。
例えば、3個の潜在変数を使用した場合の成分濃度の予測モデルは、次のように表すことができます。
\(\hat{y}\):予測された成分濃度
\(t_1,t_2,t_3\):各潜在変数のスコア
\(a_0\):切片
\(a_1,a_2,a_3\):回帰係数
使用する潜在変数が少なすぎると必要な情報を十分に表現できず精度がでない、逆に多すぎるとノイズまで学習してしまい未知のサンプルに対する精度がでないという状況になる可能性があるので、潜在変数の数を適切に選択することが重要になります。
ここまでの内容で、結局PCAを行い次元を圧縮した後に回帰解析をしているのではないかと思われるのではないかと思います。
そこで、ここからはPCAとPLS回帰の違いについて解説していきます。
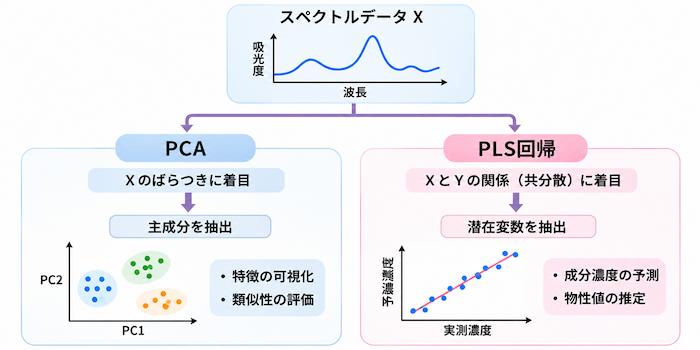
主成分分析(PCA)は、多数の説明変数を少数の主成分に集約する手法です。
PCAでは、データ全体のばらつきをできるだけ多く説明する方向を主成分として求めます。そのため、スペクトルデータの特徴を整理したり、試料間の類似性を評価したりするのに適しています。
ここで注意するべきなのが、PCAで抽出する主成分は、必ずしも成分濃度の予測に適しているとは限らないという点です。
PLS回帰も、PCAと同様に多数の説明変数を少数の変数に集約します。
ただし、PCAが説明変数のばらつきに着目するのに対して、PLS回帰は説明変数と目的変数の関係に着目します。
具体的には、PLS回帰では説明変数Xと目的変数Yの共分散を大きくする方向を考慮しながら潜在変数を抽出します。
そのため、PLS回帰では、成分濃度などの目的変数の予測に役立つ情報を抽出しやすくなります。
PCAとPLS回帰の次元の圧縮部分を比較した際の違いは、以下のような点です。
| 項目 | PCA | PLS回帰 |
|---|---|---|
| 主な目的 | データの特徴抽出・次元削減 | 目的変数の予測 |
| 目的変数Y | 使用しない | 使用する |
| 変数の抽出基準 | Xの分散 | XとYの共分散 |
| 抽出する変数 | 主成分 | 潜在変数 |
| 主な用途 | 分類・異常検知 | 成分濃度・物性値 |
PLS回帰による定量分析をPythonで実装する際には、データの準備からモデルの構築、予測精度の評価まで、一連の処理を適切な順序で行うことが必要となります。
そして、この順序は、実際にプログラムを作成する際の基本的な流れにもなります。
そこで、ここではPythonによるプログラム実装の順序を理解するために、PLS回帰による定量分析の手順を8つのSTEPに分けて解説します。
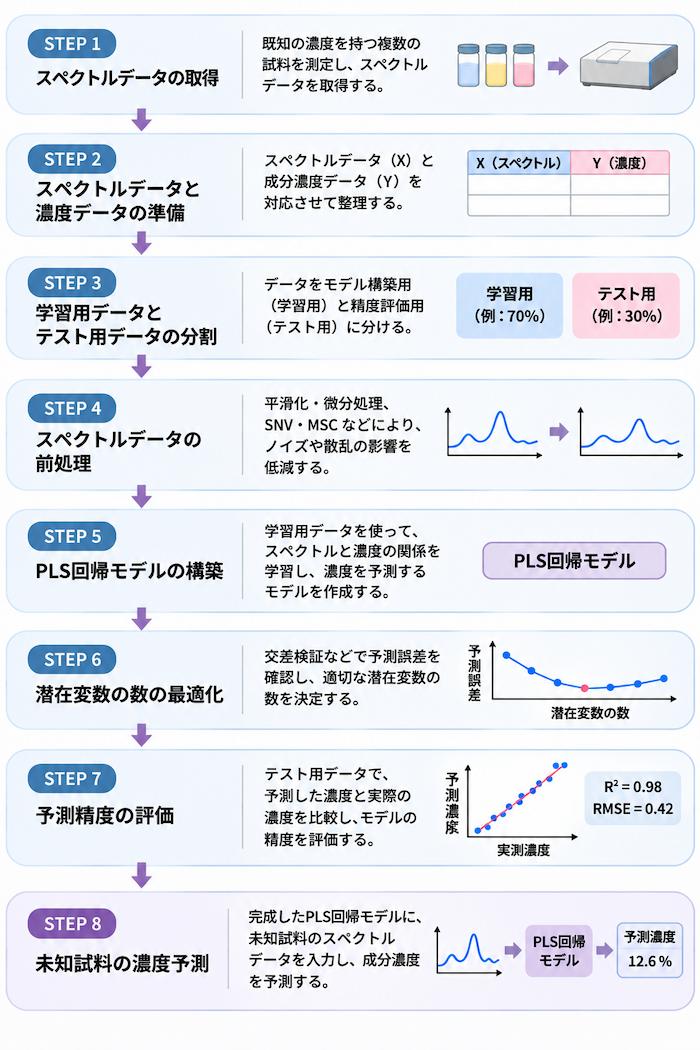
成分濃度がわかっている複数の試料を用意し、それぞれのスペクトルデータを測定します。
取得したスペクトルデータと、各試料の成分濃度を対応させて整理します。
この時、スペクトルデータを説明変数X、成分濃度を目的変数Yとします。
用意したデータを、PLS回帰モデルを構築するための「学習用データ」と、モデルの予測精度を評価するための「テスト用データ」に分けます。
学習用データは、スペクトルデータと成分濃度の関係を学習し、予測モデルを構築するために使用します。
一方、テスト用データはモデルの構築には使用せず、完成したモデルが未知の試料に対しても正しく濃度を予測できるかを確認するために使用します。
例えば、100個の試料がある場合、80個を学習用データ、残りの20個をテスト用データに分けることで、学習に使用していない試料に対する予測精度を評価できます。
測定したスペクトルデータには、ノイズやベースラインの変動、光の散乱などの影響が含まれていることがあります。
そのため、必要に応じて、平滑化によるノイズの低減、微分処理によるスペクトルの特徴強調、SNVやMSCによる散乱の影響の補正などを行います。
これにより、測定条件や試料の状態による不要な変動を抑え、成分濃度に関係する情報を抽出しやすくします。
学習用データを使って、スペクトルデータと成分濃度の関係を学習し、濃度を予測するためのPLS回帰モデルを構築します。
Pythonでは、機械学習ライブラリ「scikit-learn」の「PLSRegression」を使用することで、PLS回帰モデルを構築できます。
具体的なコマンドの内容やプログラムの書き方については、次からの記事で詳しく解説していきます。
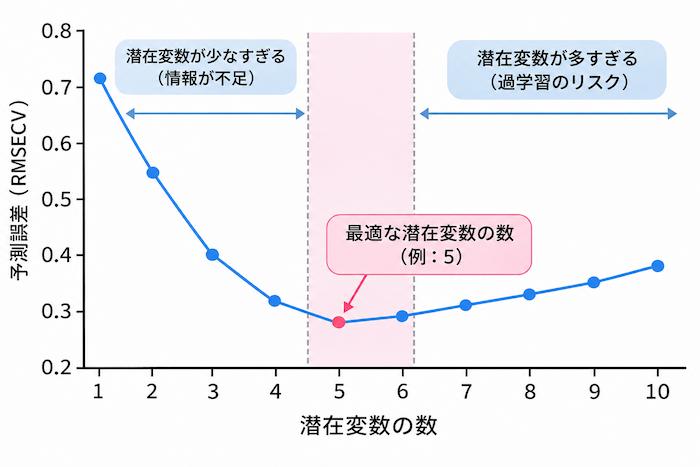
交差検証などを使って、予測誤差を確認しながら、濃度予測に適した潜在変数の数を決定します。
先にも述べていますが、潜在変数が少なすぎる場合、スペクトルデータに含まれる情報を十分に抽出できない可能性があり、潜在変数を増やしすぎると、測定ノイズや学習用データに固有の変動を学習してしまい、過学習になってしまいます。
そのため、PLS回帰では、適切な潜在変数の数を選択することが重要です。
テスト用データを使って、モデルが予測した濃度と実際の濃度を比較し、どの程度正確に予測できているかを確認します。
代表的な評価指標として、決定係数(R²)や二乗平均平方根誤差(RMSE)などがあります。
モデルが目的変数の変動をどの程度説明できているかを表す指標で、1に近いほど予測値と実測値の一致度が高いことを示します。
以下の数式のように、「予測値と実測値の差の2乗和」を「実測値とその平均値の差の2乗和」で割り、その値を1から引くことで求められます。
\[ R^2 = 1 - \frac{ \displaystyle\sum_{i=1}^{n}(y_i-\hat{y}_i)^2 }{ \displaystyle\sum_{i=1}^{n}(y_i-\bar{y})^2 } \]
つまり、実測値全体のばらつきに対して、予測誤差が小さいほど、1から引く数が小さくなり、値が1に近づきます。
Pythonでは、「scikit-learn」の「r2_score()」を使用することで、実測値と予測値から決定係数(R²)を計算できます。
モデルによる予測値と実測値の誤差が、どの程度あるかを表す指標で、値が小さいほど予測精度が高いことを示します。
以下の数式のように、「予測値と実測値の差の2乗和」を試料数で割り、その平方根を求めることで計算されます。
\[ RMSE=\sqrt{\frac{1}{n}\sum_{i=1}^{n}(y_i-\hat{y}_i)^2} \]
\(n\):試料数
\(y_i\):実測値
\(\hat{y}_i\):予測値
つまり、予測値と実測値のずれの大きさを表しており、RMSEが0に近いほど予測誤差が小さいことを示します。
また、RMSEは実測値と同じ単位で表されるため、濃度予測の場合は、予測誤差を濃度の単位で把握できます。
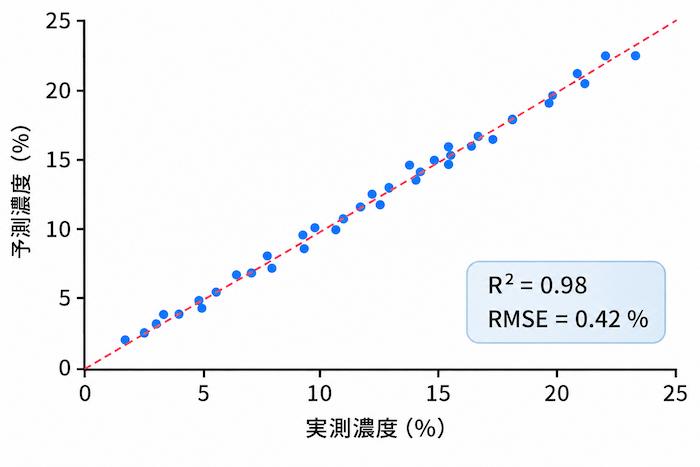
Pythonでは、「scikit-learn」の「root_mean_squared_error()」を使用することで、実測値と予測値からRMSEを計算できます。
また、Pythonのグラフ描画ライブラリ「Matplotlib」の「pyplot」を使用して、実測値と予測値を散布図にすることで、モデルの予測結果を視覚的に確認することもできます。
最後に、完成したPLS回帰モデルに、成分濃度がわからない未知試料のスペクトルデータを入力し、濃度を予測します。
未知試料のスペクトルデータには、モデルの構築時と同じ前処理を適用する必要があります。
PLS回帰モデルは、学習用データから求めたスペクトルと成分濃度の関係を利用して、未知試料の成分濃度を数値として出力することができます。
Pythonでは、「scikit-learn」の「PLSRegression」で構築したモデルに対して「predict()」メソッドを使用することで、未知試料の成分濃度を予測します。
本記事では、スペクトルデータを用いた定量分析の手法として、PLS回帰の基本的な仕組みを解説しました。
PLS回帰は、多数の波長情報を少数の潜在変数に集約し、成分濃度などの目的変数を予測する多変量解析手法です。
そして、スペクトルデータのように説明変数の数が多く、波長間に強い相関が存在するデータに適しています。
一方で、PLS回帰による定量分析では、適切な前処理や潜在変数の数の選択、予測精度の評価などに難しさもあります。
次の記事では、Pythonの機械学習ライブラリであるscikit-learnを使用して、実際にスペクトルデータからPLS回帰モデルを構築する方法を解説します。