[2.2] Pythonで主成分分析(PCA)を行う
③Pythonサンプルプログラム編
ここまでの記事では、PCA(主成分分析)の基本的な考え方と、PythonでPCAを実行するための基本的なコマンドについて解説してきました。
本記事では、これまでに学んだ内容を組み合わせて、実際のスペクトルデータにPCAを適用するプログラムを紹介します。
1. PCAの基礎とコマンド
まずは、これまでの記事の内容を簡単に振り返ります。
1.1 基礎知識編:PCAで何ができるのか
基礎知識編では、PCAが多数の変数を持つデータのばらつきを整理し、PC1、PC2といった少数の主成分でデータの特徴を表現する手法であることを解説しました。 また、PCAの結果を確認するための、「寄与率」「スコア」「ローディング」の意味も解説しています。
→[2.2] Pythonで主成分分析(PCA)を行う ①基礎知識編
1.2 Pythonコマンド編:PCAを実行する方法
Pythonコマンド編では、scikit-learnを使用してPCAを実行するための基本的なコマンドについて解説しました。
'PCA()'コマンドでPCAの条件を設定し、'fit_transform()'コマンドでPCAを実行することで、各サンプルの主成分スコアを取得できます。
また、PCAを実行した後は、'explained_variance_ratio_'コマンドで各主成分の寄与率、'components_'コマンドで各主成分を構成する波長ごとの係数を取得できます。
→[[2.2] Pythonで主成分分析(PCA)を行う ②Pythonコマンド編
2. Pythonを用いたPCAのプログラム
2.1 Pythonを用いたPCAのフロー
プログラム全体の流れを紹介します。
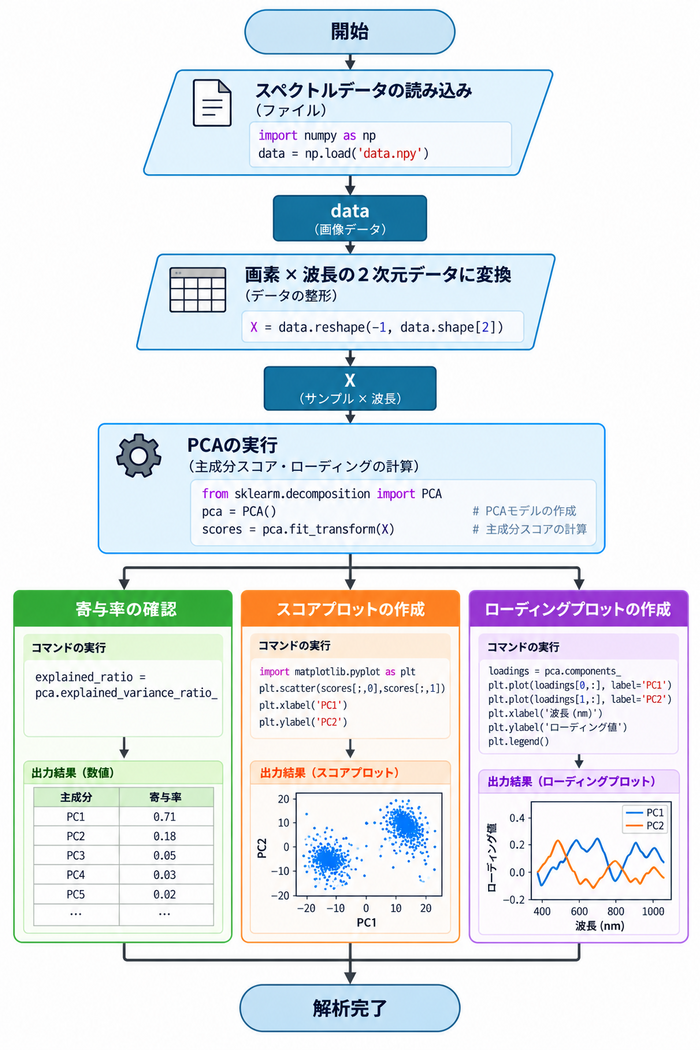
まず、ハイパースペクトルデータを読み込み、「高さ × 幅 × 波長」の3次元配列を、PCAで扱える「画素 × 波長」の2次元配列'X'に変換します。
次に、PCA()でPCAの条件を設定し、fit_transform(X)を使って2次元配列’X'に対してPCAを実行します。
これにより、各画素の主成分スコアが'scores'として得られます。
PCAを実行した後は、 'explained_variance_ratio_'で寄与率を確認し、 'scores'からスコアプロットを作成します。 さらに、'components_'を使ってローディングプロットを作成します。
このように、今回のプログラムではPCAを実行するだけでなく、 「スペクトルにどのような違いがあるのか」、「その違いにどの波長が関係しているのか」 まで確認していきます。
2.2 Pythonを用いたPCAのサンプルプログラム
import spectral
import numpy as np
import matplotlib.pyplot as plt
from sklearn.decomposition import PCA

# ==========================================
# 1. データの読み込みと変換
# ==========================================
img = spectral.open_image("/path/spectral_data.hdr")
data = np.asarray(img.load())
wavelengths = np.array(img.bands.centers)

height, width, bands = data.shape
X = data.reshape(-1, bands)

# ==========================================
# 2. PCAの実行
# ==========================================
pca = PCA(n_components=2)
scores = pca.fit_transform(X)

# ==========================================
# 3-1. 寄与率の確認
# ==========================================
ratio = pca.explained_variance_ratio_
print(f"PC1 寄与率:{ratio[0] * 100:.1f}%")
print(f"PC2 寄与率:{ratio[1] * 100:.1f}%")

# ==========================================
# 3-2. スコアプロット
# ==========================================
plt.scatter(scores[:, 0], scores[:, 1], s=5)
plt.xlabel(f"PC1 ({ratio[0] * 100:.1f}%)")
plt.ylabel(f"PC2 ({ratio[1] * 100:.1f}%)")
plt.title("PCA Score Plot")
plt.show()

# ==========================================
# 3-3. ローディングプロット
# ==========================================
loadings = pca.components_
plt.plot(wavelengths, loadings[0], label="PC1")
plt.plot(wavelengths, loadings[1], label="PC2")
plt.xlabel("Wavelength")
plt.ylabel("Loading")
plt.title("PCA Loading Plot")
plt.legend()
plt.show()
3. Pythonを用いたPCAのサンプルプログラムの解説
ここからは、それぞれのプログラムの中身を説明していきます。[1] スペクトルデータの読み込みと変換
img = spectral.open_image("/path/spectral_data.hdr")
data = np.asarray(img.load())
wavelengths = np.array(img.bands.centers)

height, width, bands = data.shape
X = data.reshape(-1, bands)
まず、Spectral Pythonを使用してハイパースペクトルデータを読み込みます。
'spectral.open_image()'でデータを読み込み、'np.asarray(img.load())'によってNumPy配列に変換します。
読み込んだデータは「高さ × 幅 × 波長」の3次元配列となるため、 PCAで扱えるように'reshape()'を使用して「画素 × 波長」の2次元配列'X'に変換します。
この'X'では、1行が1画素のスペクトル、各列がそれぞれの波長に対応します。
Spectral Pythonを使ったハイパースペクトルデータの読み込み方法については、以下の記事で詳しく解説しています。
→ ハイパースペクトルデータをSpectral Pythonで読み込む方法
解説に使用するサンプルのスペクトルデータ
今回は、乾燥試料と水分を含む試料の近赤外反射スペクトルをサンプルとして使用します。 PCAによるスペクトル解析の流れを分かりやすく説明するために作成した模擬的なデータです。
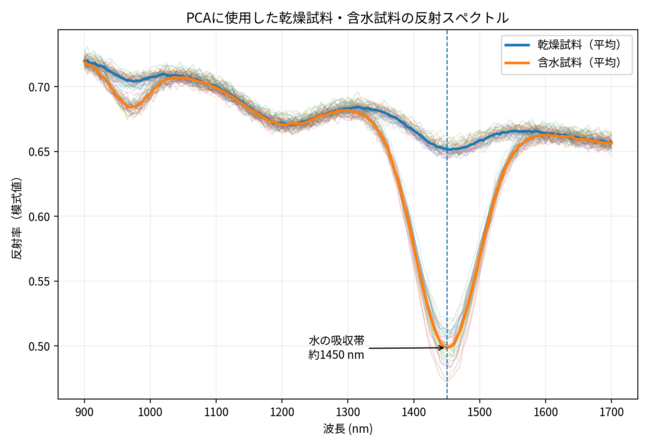
上記の図は、今回の解析で使用する乾燥試料と含水試料の近赤外反射スペクトルを示したものです。
水は970 nm付近や1450 nm付近にO-H結合に由来する吸収帯があるため、 水分を多く含む試料ほど、それらの波長付近で光が吸収され、反射率が低くなる傾向があります。
そこで今回の模擬データでは、含水試料について970 nm付近と1450 nm付近の反射率が低くなるように設定しています。
[2] PCAの実行
pca = PCA(n_components=2)
scores = pca.fit_transform(X)
この2行で、読み込んだスペクトルデータ'X'に対して、scikit-learnのPCAを使用して主成分分析を実行します。
今回は、'PCA()'に'n_components=2'を設定することで、使用する主成分の数を2つ(PC1、PC2)に設定しています。
続いて、'fit_transform(X)'によってPCAを実行します。
この処理により、スペクトルデータ'X'から主成分を求めると同時に、各画素のスペクトルを主成分空間へ変換します。
PCAの結果として、各画素のPC1、PC2のスコア(座標)が'scores'に格納されます。
格納されるスコア行列のイメージ
| 画素 | PC1スコア | PC2スコア |
|---|---|---|
| 画素1 | -2.15 | 0.32 |
| 画素2 | -1.87 | 0.25 |
| 画素3 | 1.42 | -0.18 |
| 画素4 | 2.03 | -0.41 |
このスコアを散布図として表示したものが「スコアプロット」です。 スコアプロットについては、[3-2]で実際の解析結果とあわせて確認します。
なお、scikit-learnのPCAでは、PCAを実行する際に各変数(各波長)の平均値を引く中心化が自動的に行われます。
そのため、今回の例では事前に中心化する前処理を行っていません。
PCAを実行した後は、「寄与率」「スコアプロット」「ローディングプロット」の3つを確認し、スペクトルデータの特徴を解析していきます。
[3-1] 寄与率の確認
ratio = pca.explained_variance_ratio_

print(f"PC1 寄与率:{ratio[0] * 100:.1f}%")
print(f"PC2 寄与率:{ratio[1] * 100:.1f}%")
まずは、各主成分が元のスペクトルデータのばらつきをどの程度説明しているのかを寄与率で確認します。
'explained_variance_ratio_'には、各主成分がデータ全体のばらつきをどの程度説明しているかが割合で格納されています。
模擬データでの寄与率の結果
PC1:98.3%
PC2:1.0%
今回の場合、PC1だけでデータ全体のばらつきの98.3%を説明していることが分かります。 さらに、PC1とPC2を合わせると約99.3%となり、元のスペクトルデータに含まれる主要なばらつきの大部分を2つの主成分で表現できていると言えます。
ただし、寄与率を確認するだけでは、PC1がどのようなスペクトルの違いを捉えているのかまでは分かりません。
そこで次に、各スペクトルがPC1とPC2上でどのように分布しているのかをスコアプロットで確認します。
[3-2] スコアプロット
plt.scatter(scores[:, 0], scores[:, 1], s=5)
plt.xlabel(f"PC1 ({ratio[0] * 100:.1f}%)")
plt.ylabel(f"PC2 ({ratio[1] * 100:.1f}%)")
plt.title("PCA Score Plot")
plt.show()
PCAによって得られた'scores'を散布図として表示します。
'scores'行列の1列目('scores[:, 0]')には各画素のPC1スコア、2列目('scores[:, 1]')にはPC2スコアが格納されています。
そのため、1列目をX軸、2列目をY軸に指定して散布図を描くことで、PC1とPC2のスコアプロットを作成できます。
また、X軸とY軸のラベルには、[3-1]で求めた寄与率を表示しています。
これにより、PC1とPC2が元のスペクトルデータのばらつきをどの程度説明しているのかを確認しながら、スコアプロットを見ることができます。
模擬データでのスコアプロットの結果
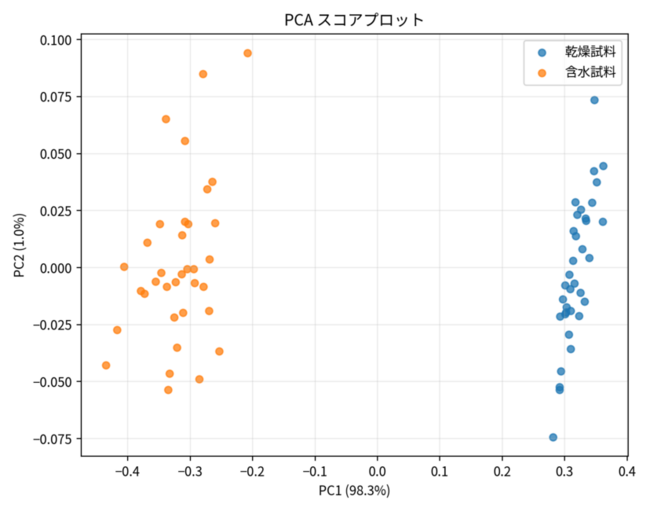
スコアプロット上の1つの点は、1画素のスペクトルデータに対応しています。
互いに近い位置にある点はPCAによって抽出されたスペクトルの特徴が似ており、離れている点は異なる特徴を持っていると考えることができます。
今回の結果を見ると、乾燥試料と含水試料は主にPC1方向で異なる位置に分布しています。
このことから、乾燥試料と含水試料のスペクトルの違いがPC1に強く反映されていることが分かります。
つまり、今回の模擬データでは、スペクトルの特徴によって乾燥試料と含水試料を区別できる可能性があることをスコアプロットから確認できます。
ただし、PCA自体が「乾燥」「含水」というラベルを判定して分類しているわけではありません。 PCAによってスペクトルの特徴を整理した結果、2つの試料が異なる位置に分布していることを確認している点には注意が必要です。
ここで気になるのが、なぜ乾燥試料と含水試料がPC1方向に分かれたのかということだと思います。
その違いにどの波長が関係しているのかを考察するために、次にローディングプロットを確認します。
[3-3] ローディングプロット
loadings = pca.components_

plt.plot(wavelengths, loadings[0], label="PC1")
plt.plot(wavelengths, loadings[1], label="PC2")

plt.xlabel("Wavelength")
plt.ylabel("Loading")
plt.title("PCA Loading Plot")
plt.legend()
plt.show()
最後に、PCAによって得られたローディングを波長ごとにプロットします。
'pca.components_'には、各主成分を構成する波長ごとの係数が格納されています。 今回は'n_components=2'としているため、'loadings[0]'がPC1、'loadings[1]'がPC2に対応します。
スペクトルのローディングプロットは、横軸に波長、縦軸にローディングを表示します。 ローディングの絶対値が大きい波長ほど、その主成分を構成するうえで強く関係していると考えることができます。
模擬データでのローディングプロットの結果
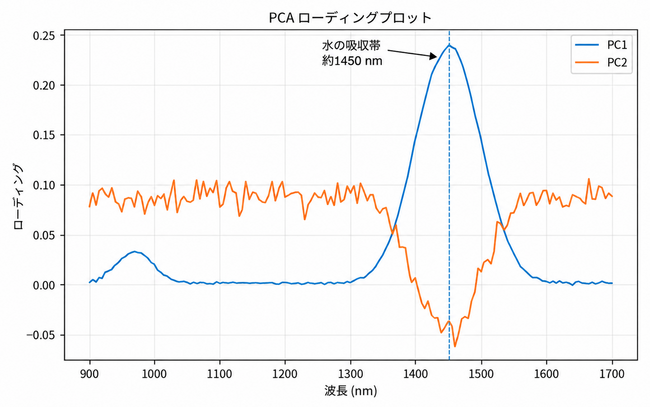
今回のPC1のローディングを見ると、1450 nm付近に大きな特徴が現れています。
今回の模擬データでは、水分量の違いによって、水の吸収帯である1450 nm付近に大きなスペクトルの違いが現れるように設定しています。 そのため、PC1が乾燥試料と含水試料のスペクトルの違いを捉え、その違いに1450 nm付近の波長が強く関係していることが読み取れます。
4. サンプルデータの考察
ここまで、乾燥試料と含水試料の模擬データを使用して、 PCAの寄与率、スコアプロット、ローディングプロットを確認してきました。
今回の結果を整理すると、次のような流れで解釈できます。
「水分量の違い」
↓
「1450 nm付近の反射スペクトルが変化」
↓
「1450 nm付近のスペクトルの違いをPC1が捉える」
↓
「スコアプロット上で乾燥試料と含水試料が主にPC1方向に分かれる」
4.1 スコアとローディングを組み合わせて考察
PCAによるスペクトル解析では、スコアプロットとローディングプロットを組み合わせて結果を確認することが重要です。
スコアプロットでは「どのサンプルのスペクトルが異なるのか」を確認し、 ローディングプロットでは「その違いにどの波長が関係しているのか」を考察します。
今回の例では、スコアプロットから乾燥試料と含水試料が主にPC1方向で異なる位置に分布していることが確認できました。
さらに、PC1のローディングプロットでは1450 nm付近に大きな特徴が見られたことから、
この波長付近のスペクトルの違いがPC1方向の分離に強く関係していると考えられます。
今回の模擬データでは、1450 nm付近は水分量の違いによって反射率が変化するように設定した波長域です。 そのため、PCAによって乾燥試料と含水試料のスペクトルの違いが捉えられていることを確認できます。
このようにPCAを利用すると、多数の波長から構成されるスペクトルデータを少数の主成分に整理するとともに、 サンプル間の違いと、その違いに関係する波長を結び付けて解析することができます。
5. まとめ
本記事では、Pythonのscikit-learnを使用してスペクトルデータにPCA(主成分分析)を適用する方法について、 サンプルプログラムを使いながら解説しました。
スペクトルデータは多数の波長から構成されているため、そのままではデータ全体の特徴やサンプル間の違いを把握することが難しい場合があります。 PCAを利用することで、多数の波長が持つばらつきをPC1、PC2などの少数の主成分に整理し、データの特徴を捉えやすくすることができます。
本記事では、scikit-learnのライブラリを使用することで、 多数の波長を持つスペクトルデータの特徴を整理し、 サンプル間の違いや、その違いに関係する波長を分析できることを紹介しました。
本記事で紹介したPCAの内容やPythonでの解析方法が、スペクトルデータを解析する際の一助となれば幸いです。
このカテゴリのコンテンツ
関連コンテンツ
ハイパースペクトルカメラコース
スペクトルカメラ知識コンテンツ
スペクトルカメラ技術基礎
スペクトル解析
- 主成分分析(PCA)で物質の分類
- 部分的最小二乗回帰(PLS)で成分を定量化
- スペクトルの多変量解析
- 多変量解析の実例
- Pythonで始めるスペクトル解析
- 1.1 スペクトルデータの読み込み
- 1.2 スペクトルデータ画像表示
- 1.3 スペクトルグラフ表示
- 1.4 スペクトルビューア作成
- 2.1 前処理 1)輝度値補正
- 2.1 前処理 2)ノイズ低減/特徴強調
- 2.1 前処理 3)ノイズ低減/特徴強調
- 2.2 PCA 1)基礎知識
- 2.2 PCA 2)Pythonコマンド
- 2.2 PCA 3)サンプルプログラム
- スペクトルデータベースの調べ方
多変量解析
スペクトル解析プロブラム
スペクトルDB
スペクトルカメラ論文
スペクトルカメラの選び方
スペクトルカメラのデモ
スペクトルカメラアプリケーション
- ハイパースペクトルカメラで樹脂や金属の劣化を読み解く新技術
- SDGsと光学機器・センサー
- ハイパースペクトルカメラ事例集
- 見えない異物を検出
- 国内・国外での鉱物資源の迅速な探査と選別
- 人手不足の現状と次世代の省人化技術、ハイパースペクトルカメラの可能性
- ハイパースペクトルカメラによるカーボンニュートラル実現に向けた技術革新の効率化
- ハイパースペクトルカメラで加速する脱プラスチック
- ハイパースペクトルカメラがもたらすDX
- 膜厚測定
- クロロフィル測定とは?
- 偽造防止印刷とは?
- 近赤外分光で繊維選別
- ハイパースペクトルカメラ事例|工業分野
- プラスチック資源循環促進法とは
- 近赤外分光でプラスティック選別
- 半導体・フィルムの膜厚測定
- マシンビジョンでの活用事例
- ハイパースペクトルカメラ事例|食品分野
- 食品産業業界の未来を考える
- 食品産業で活躍するIoTセンサー
- ハイパースペクトルカメラ事例|医療分野
- 医療分野での活用
- ハイパースペクトルカメラ事例|インフラ分野
- インフラ(コンクリート)の維持保全
- ハイパースペクトルカメラ事例|防衛・セキュリティー分野
- ハイパースペクトルカメラ事例|リモートセンシング
- ハイパースペクトルカメラ事例|農業分野